Esta página trata sobre cómo se genera el habla: clips concatenativos, vocoders paramétricos, audio sin procesar al estilo WaveNet y los modelos neuronales que GSpeech enruta hoy. No es una lista de "por qué agregar un reproductor", eso vive en Beneficios de TTS del sitio webTampoco se trata de un tutorial de instalación de WordPress.
En un sitio en vivo no eliges un documento de investigación. Eliges una voz en la consola de Cloud. Bajo esa elección, Motor de voz con IA unificado (Comercial) Puede utilizar OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot y WaveNet. No se requieren claves API. El procesamiento en la nube, sin carga de servidor, mantiene la síntesis fuera de su origen.
El proceso de síntesis (lo que realmente sucede)
Síntesis del habla Convierte tokens escritos en una forma de onda. Un reproductor web es solo el último paso: reproducir un archivo. El trabajo interesante está en la etapa anterior.
- Texto en - Artículo aislado, segmento resaltado (RHT) o cadena traducida. El aislamiento es un trabajo de producto, no un documento de vocoder.
- Análisis lingüístico - palabras, énfasis, pausas. Los alias de pronunciación inteligente se encuentran aquí: cadenas de marca que el modelo adivinaría de otro modo.
- Modelo acústico - unidades concatenativa, un vocoder paramétrico o una red neuronal que predice audio.
- Salida de forma de onda - Almacenado una vez bajo Generar una vez, conservar y reproducir, y luego transmitido. Navegador speechSynthesis Omite esta tienda y utiliza lo que venga incluido con el sistema operativo.
Tres familias de modelos TTS
TTS concatenativo Almacena fragmentos cortos de audio y los recombina. Cambiar de interlocutor o de emoción suele implicar grabar una nueva base de datos. Las funciones clásicas de Siri utilizaban esta idea.
TTS paramétrico conserva rasgos del habla en parámetros del modelo. Las primeras versiones a menudo sonaban menos naturales que la concatenación porque el audio pasaba por un vocoder.
Los sistemas neuronales se basan en esa historia. Los modelos estadísticos y basados en reglas aún existen en los libros de texto. Lo que escuchas en las voces comerciales de GSpeech es síntesis de IA: OpenAI, Gemini, Google Cloud Neural2/Polyglot/Chirp3 HD y WaveNet, no un banco concatenativo local en tu servidor PHP.
WaveNet: modelado de la forma de onda original
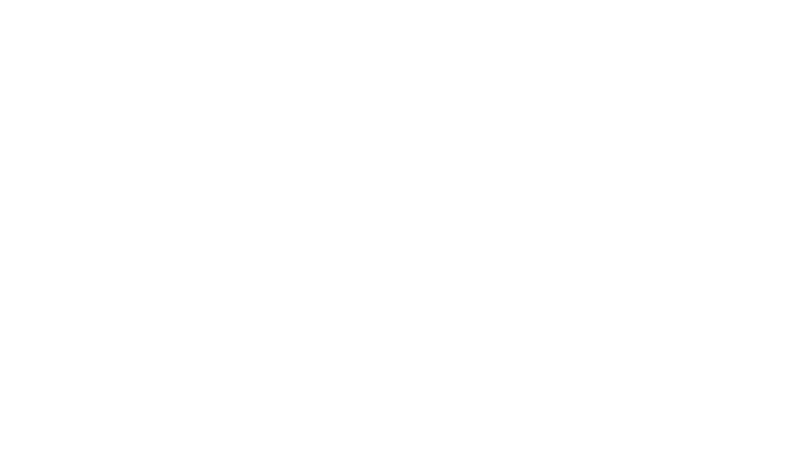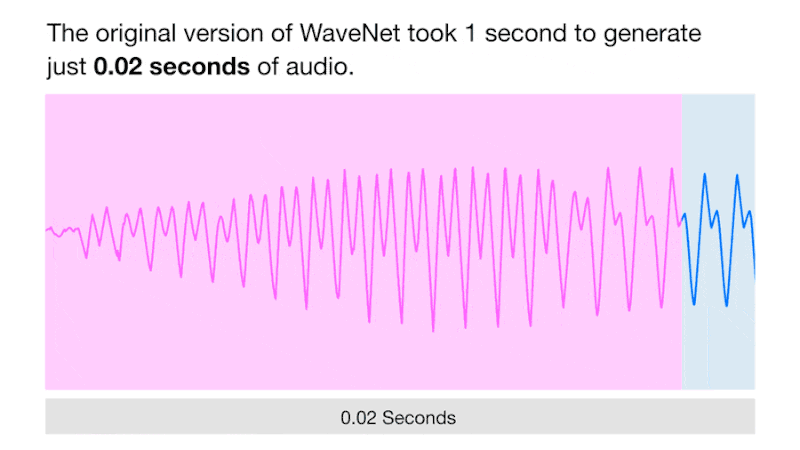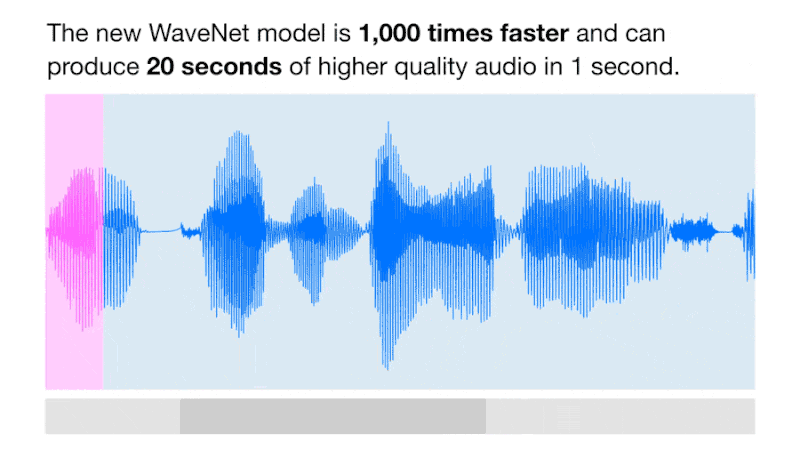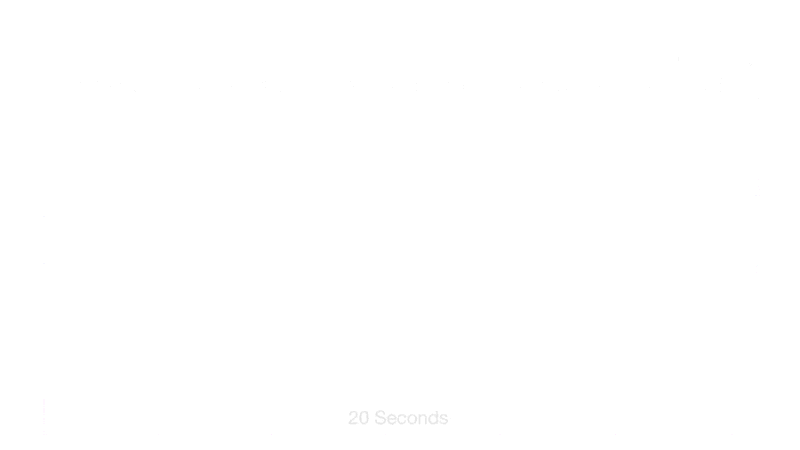
WaveNet revolucionó la metodología paramétrica al predecir la señal de audio muestra a muestra, en lugar de proporcionar un espectrograma compacto a un vocoder. El trabajo de Google de 2016 demostró que una red convolucional dilatada puede abarcar miles de pasos de tiempo. El audio sin procesar es denso (normalmente 16 000 muestras por segundo o más), por lo que la generación autorregresiva resulta costosa, pero captura sutilezas como chasquidos de labios y peculiaridades del hablante que la concatenación tradicional suele pasar por alto.
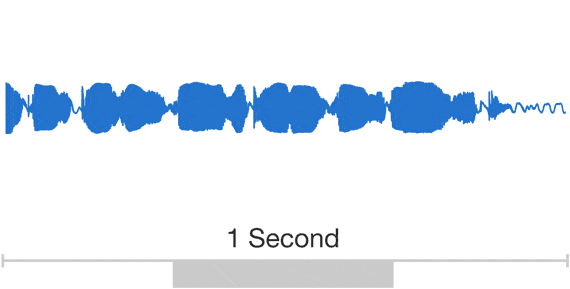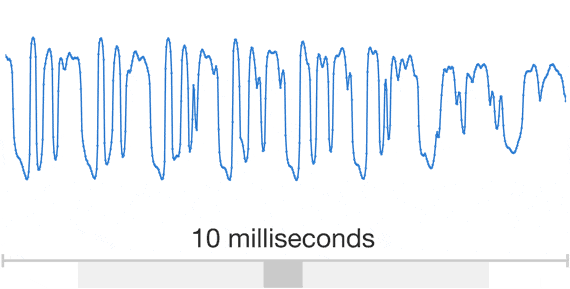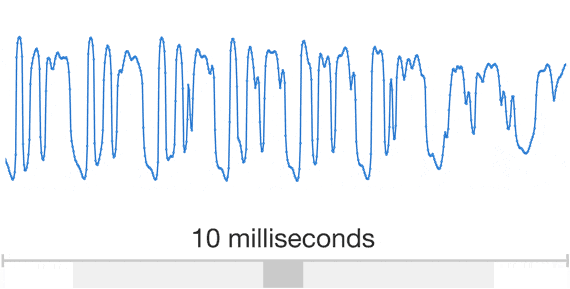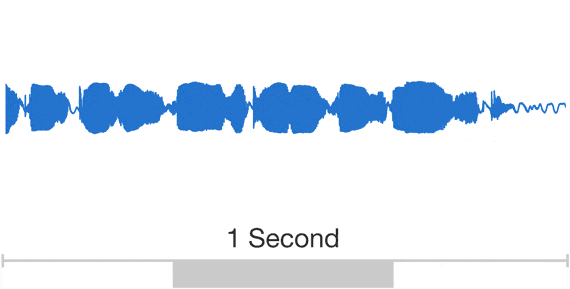
PixelRNN y PixelCNN Se demostró que era posible generar una imagen canal por canal. WaveNet es la versión unidimensional de esa idea: una red totalmente convolucional cuyos factores de dilatación aumentan el campo receptivo exponencialmente.
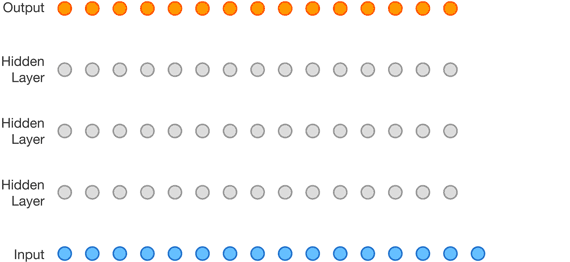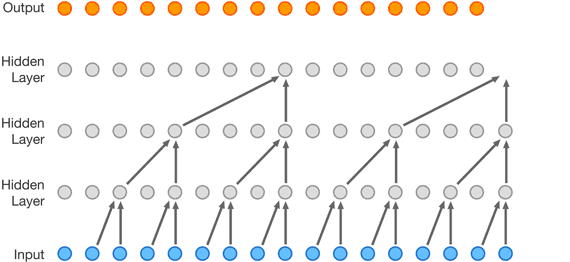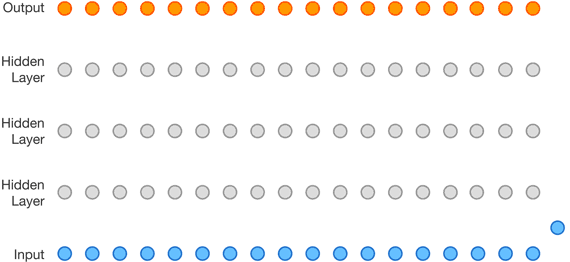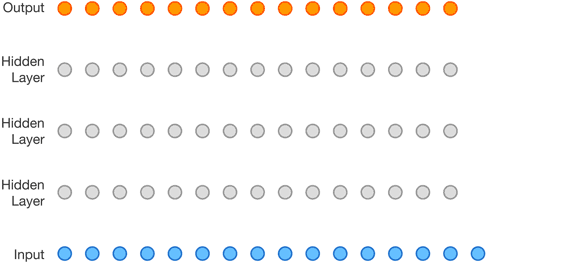
Durante el entrenamiento, las entradas son formas de onda reales grabadas. En el muestreo, cada paso extrae una muestra de la distribución predicha por la red, la retroalimenta y continúa. Este ciclo explica por qué WaveNet en sus inicios se limitaba al procesamiento para investigación; posteriormente, las nuevas versiones lo simplificaron para su uso en la plataforma de síntesis de voz de Google.
MOS y la brecha de 2016
Google evaluó WaveNet frente a los mejores sistemas paramétricos y concatenantes en ese momento utilizando Puntuaciones de opinión medias (MOS) - Evaluaciones humanas a ciegas (más de 500 evaluaciones en 100 frases de prueba en el informe original). WaveNet redujo la brecha restante con el habla humana en más de la mitad para el inglés estadounidense y el chino mandarín en esas pruebas. Esto representa un hito en la investigación, no una puntuación de marketing de GSpeech.
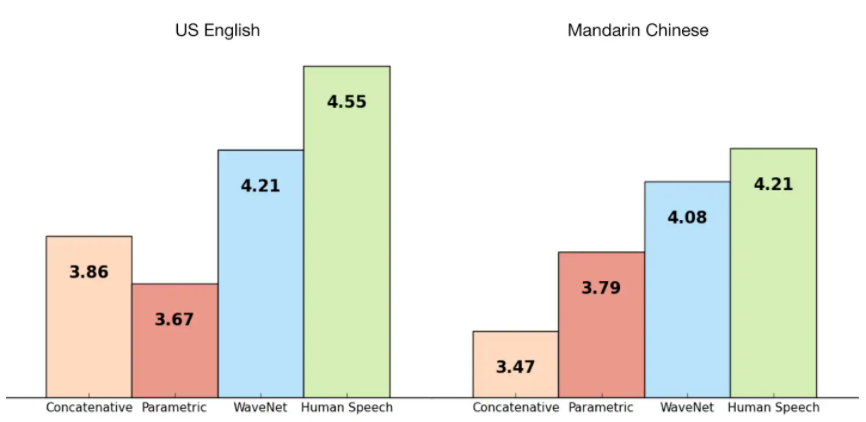
WaveNet es una familia en el Motor de Voz de IA Unificada. Pilas posteriores - Géminis TTS, Chirp3 HDNeural2, Polyglot y OpenAI son las opciones que seleccionas como voz en la consola de Cloud. No implementas un punto de control de WaveNet en WordPress.
Gemini TTS: habla controlada por indicaciones
WaveNet predijo la siguiente muestra de audio. Géminis TTS es una ruta de generación de voz de Google posterior: usted describe cómo debe sonar la lectura en lenguaje natural (estilo, acento, ritmo, tono, emoción, entonación) y el modelo ejecuta esa dirección. Por eso GSpeech indicaciones de voz personalizadas y Vibraciones de voz En Gemini, lo que importa son los estilos, no los identificadores de voz adicionales: el control reside en el mensaje, no en un nuevo banco concatenativo.
La limpieza lingüística sigue ocurriendo primero. Los alias de pronunciación inteligente pueden expandir un acrónimo o bloquear un token de marca; luego, Gemini pronuncia la cadena preparada con la entrega solicitada. Notas oficiales de la API: Géminis TTS.
Narración Gemini de máxima fidelidad cuando el pase de escucha forma parte de la página: publicaciones destacadas, explicaciones de marca, textos de productos.
El mismo lenguaje de mensajes que en la versión Pro, optimizado para una generación más rápida en un catálogo de publicaciones o SKU.
Gemini Pro
Gemini Pro Es el modelo Gemini TTS ultrarrealista integrado en GSpeech. Escribes una sugerencia de voz personalizada como si se la dirigieras a un narrador: una explicación de producto más tranquila, un blog más dinámico, un acento más marcado, un ritmo más pausado y mayor emotividad. El código HTML visible se mantiene limpio para los lectores y el SEO. No se requiere una clave Gemini independiente, ni un proyecto de Google AI Studio, ni una consola de proveedor adicional.
Técnicamente, esto sigue siendo síntesis en la nube, y luego un archivo almacenado. Las escuchas repetidas son reproducción, no un viaje completo de Gemini. Usa Pro cuando el audio sea la experiencia principal: un artículo destacado o la página de un producto donde la presentación debe ser personalizada, no genérica.
Gemini Flash
Gemini Flash Pertenece a la misma familia Gemini TTS, diseñada para la velocidad. El vocabulario de las indicaciones coincide con el de Pro (estilo, acento, ritmo, tono, emoción, entonación), por lo que puedes redactar una indicación de voz una sola vez y reutilizarla mientras Flash carga las páginas más rápido. Herramienta indispensable para catálogos: múltiples publicaciones, descripciones de WooCommerce, borradores multilingües. Promociona una URL principal a Pro cuando necesites el máximo rendimiento.
Chirp3 HD: Google Cloud’s current HD neural family
Chirp3 HD No es “WaveNet con un nombre nuevo”. WaveNet (2016) modeló audio sin procesar con convoluciones dilatadas. Las voces de Neural2, Polyglot y WaveNet aún se encuentran en el catálogo de Google Cloud (el 230+ piso: Standard, WaveNet, Neural2, Polyglot, Journey, Studio, News). Chirp3 HD es la última generación de Cloud TTS de alta definición de Google, diseñada para el realismo y la entonación natural en lugar de una lectura en voz alta plana. Notas oficiales: Chirp 3 HD.
Dentro de GSpeech, Chirp3 HD es una voz de la consola de Google Cloud: no requiere un proyecto de Google Cloud ni JSON de cuenta de servicio. Seleccionas la voz; la síntesis se ejecuta a partir de tu fuente; el archivo se almacena y se reproduce mediante Full Page, Button, Circle, Floating, Context o RHT. La velocidad y el tono se mantienen en la consola. Los nombres de marca siguen perteneciendo a Smart Pronunciation Aliases; esta capa es independiente de la familia de Google que hayas elegido.
Cuándo elegir Chirp3 HD vs Gemini: Chirp3 HD cuando se desea la calidad neuronal de producción de Google Cloud HD y una lectura consistente e independiente del dispositivo. Gemini Pro / Flash cuando se desea control de las indicaciones en lenguaje natural sobre el estilo y la emoción. Ambos son rutas comerciales de Unified AI Voice Engine. El motor total es 300+ voces en 98 idiomas, (Gemini ~30 × 3 para Chirp 3 HD, Flash y Pro por idioma, más OpenAI 11 × 2, más el catálogo de Google Cloud). Voice Vibes son estilos, no identificadores adicionales.
- Neuronal2 - Voces neuronales de producción ampliamente utilizadas en el mismo catálogo de Google Cloud.
- Polígloto - Mayor rendimiento multilingüe/interlingüístico.
- WaveNet - La familia de formas de onda sin procesar de 2016, que aún está disponible como voces de catálogo, no es la única opción de Google.
Motor de voz con IA unificado frente a la síntesis de voz del navegador
Inteligencia del speechSynthesis Es una API local. Las voces varían según el sistema operativo. No hay archivo Generar una vez, guardar y reproducir, ni Sincronización de audio inteligente cuando cambia la copia del CMS, ni capa de avisos Voice Vibes. GSpeech Cloud Processing ejecuta el modelo en la nube, almacena el archivo y el widget lo reproduce. Los problemas temporales de generación no eliminan los archivos generados previamente. Los archivos no se eliminan cuando una cuenta vuelve al plan gratuito. La nueva generación sigue el plan activo.
models:  "OpenAI, Gemini, Google Cloud, Chirp3 HD, Neural2, Polyglot, WaveNet"
langs:    "98 languages, 300+ voices (commercial)"
control: "Voice Vibes + Smart Pronunciation Aliases"
keys:    "No API Keys Required"
Voice Vibes (comercial) utiliza un estilo de indicaciones en el menú, no un nuevo banco concatenativo. Los alias modifican la forma en que se pronuncia un token sin cambiar el HTML visible. Ambos son capas de control que se superponen al modelo acústico que el motor haya seleccionado para esa voz.
Preguntas frecuentes sobre la tecnología de conversión de texto a voz
Modelos y flujos de trabajo, no configuración de complementos.
-
¿GSpeech utiliza WaveNet en cada escucha?
No. WaveNet es una de las muchas familias de Google. El motor de voz de IA unificada también enruta Neural2, Polyglot, Chirp3 HD, Gemini y OpenAI, según la voz que elijas. Generar una vez, guardar y reproducir significa que las reproducciones repetidas usan el archivo almacenado, no un nuevo bucle de muestra para investigación.
-
¿Por qué se sigue mencionando la síntesis de voz concatenativa?
Es la base histórica: unir unidades grabadas. Los modelos neuronales generan audio en lugar de pegar sílabas. Comprender la concatenación frente a WaveNet explica por qué las voces comerciales modernas pueden cambiar de estilo sin una nueva sesión de grabación.
-
¿Puedo ejecutar estos modelos en mi propio servidor?
El producto web de GSpeech se basa en el procesamiento en la nube, sin carga de servidor. No es necesario alojar WaveNet, Gemini ni OpenAI en WordPress. No se requieren claves API: la facturación y las claves se gestionan desde la consola en la nube.
-
¿Sigue vigente la norma MOS de 2016 para GSpeech en la actualidad?
La gráfica MOS de esta página corresponde a la evaluación WaveNet publicada por Google. GSpeech no afirma que esa misma puntuación se aplique a todas las voces actuales. La calidad comercial actual proviene de la combinación de motores mencionada anteriormente, no de la reimpresión de una puntuación MOS de 2016 como calificación del producto.
-
Gemini Pro vs Gemini Flash: ¿cuál es la diferencia?
La misma familia de síntesis de voz Gemini y el mismo lenguaje de voz personalizado (estilo, acento, ritmo, tono, emoción y dicción). Flash es más rápido para catálogos; Pro ofrece mayor fidelidad para páginas principales. Ninguno requiere una clave API de Gemini en GSpeech: seleccionas la voz en la consola de Cloud.
-
¿Chirp3 HD es lo mismo que WaveNet?
No. WaveNet es la familia de modelos de forma de onda sin procesar de Google de 2016. Chirp3 HD es una generación posterior de síntesis de voz en la nube de alta definición para realismo e entonación. Las voces Neural2, Polyglot y WaveNet aún existen en el catálogo de Google Cloud (más de 230). GSpeech ofrece Chirp3 HD como voz de consola sin necesidad de un proyecto de Google Cloud.
Del papel a una voz en la consola
Los bancos concatenativos, los vocoders paramétricos y la apuesta de WaveNet por la forma de onda sin procesar son el linaje. Gemini TTS (Pro / Flash) añade entrega controlada por indicaciones; Chirp3 HD es la familia neuronal HD actual de Google Cloud. En un sitio de GSpeech, puede escuchar el motor de voz de IA unificado actual a través de un widget: página completa, botón, círculo o Leer texto resaltado (RHT) - con archivos conservados después de la primera generación. Para “mi URL debería tener un reproductor”, consulte el artículo sobre beneficios. Para clics en wp-admin, consulte el tutorial.
